场景标题提取器
轻量的场景清单生成器
制片助理和编剧为了把一部电影里的每一个场景一条条列出来,常常要花上好几个小时。你只需要把完整剧本粘贴到下面。工具会逐行识别以内景、外景或内外景开头的场景标题,再输出一份干净、按字母排序的场景清单,这份清单可以直接复制进 Excel 或拆解表,省去手工整理的时间。
这个免费的场景标题提取器,是给筹备期里需要快速、可靠地列出剧本中所有场景的人用的。你不用再翻着 PDF 一条条手动复制场景标题,把剧本粘进来,几秒钟就能拿到一份可直接使用的场景清单。
提取器会逐行扫描你的剧本,寻找符合标准的场景标题,找到之后把它们收进一份去重后的清单里。它可以看作一个轻量的拆解助手,适合用来做场景清单、安排拍摄计划,以及筹备通告单等前期工作。
所有处理全部在你的浏览器里运行,没有任何剧本页会被上传或存储到服务器上。一小段 JavaScript 循环会在每一行的开头寻找精确的前缀,规整其中的空格,去掉重复的条目,最后把结果按 A 到 Z 的顺序排序输出。
这个免费的场景标题提取器怎么运作
- 把完整剧本(或某一幕、某一集)粘贴到上面的文本框里。转成文本的 PDF 导出稿和 Fountain 文件都可以,只要场景标题以标准前缀开头。
- 工具会遍历每一行,检查它是否以这些前缀开头。匹配的行会被当成场景标题,规整空格后存进一个会自动去重的集合里。
- 最终清单按字母排序,显示在第二个文本框里,一行一个场景标题,可以直接复制进 Excel、Google 表格或任何拆解软件。
这个拆解助手适合谁
- 正在整理场景清单和初步拍摄计划的副导演与制片助理。
- 想快速过一遍自己剧本、看看有多少场景以及重复得多不多的编剧。
- 还没有完整拆解软件、但依然需要一份干净可导出的场景标题清单的独立电影人。
拿到干净场景清单的几个好习惯
- 使用标准的场景标题格式,后面跟上场景名和时间(例如「内景 公寓 - 夜」)。
- 整个剧本里的场景名保持一致(例如一直写「公寓」,别一会儿写成「朱莉的公寓」)。这样之后按场景归类会容易得多。
- 如果一场戏可以在多个空间里演,考虑是否该拆成不同的场景标题,方便制作时更清楚。
- 把清单导出到 Excel 之后,加上内外景、日夜、场景类别,以及是实景还是搭建景的列。
从剧本到镜头,一站完成。
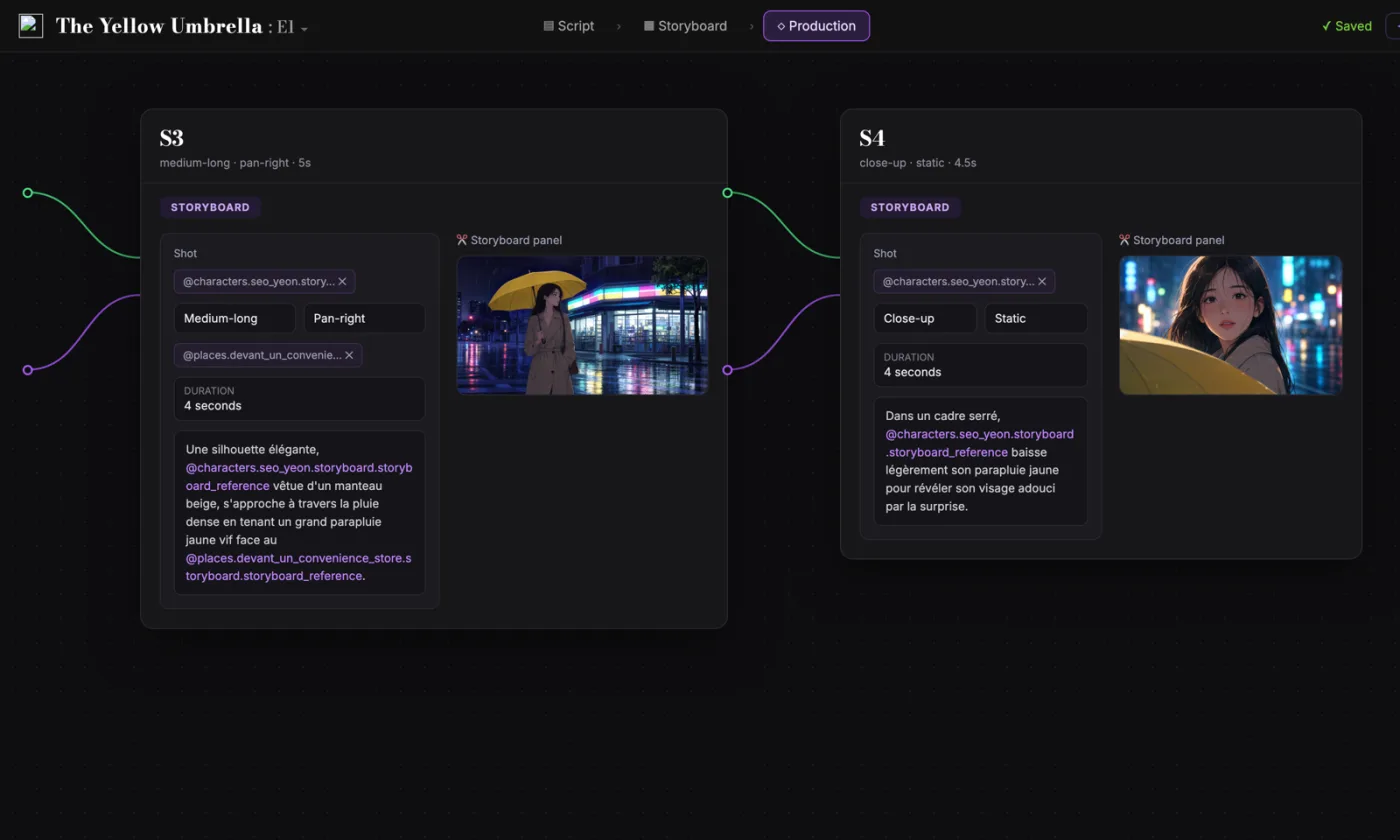
熙熙 把剧本自动拆解为镜头表,再生成分镜。角色、场景和参考图在镜头之间一路延续。
- 0 美元,永不过期
- 导出 PDF 和 Final Draft
- Mac、Windows、Linux、iPad
场次提取器:完整指南
它把剧本里的场景标题抽取出来并做去重处理,让场地规划从一份干净的数据开始,而不是从手工复制粘贴开始,后续整理起来也更省心。
这类工作的核心问题其实很清楚:手工从剧本里挑出场景地点既慢又容易出错,而且稿子一改就难以维护。如果不解决这个问题,它就会在后面的环节里制造摩擦,让决策变慢。实际要达到的目标是一份干净的场景地点清单,从而加快筹备进度,以及表格里的拆解流程。
有一条限制需要记牢:它依赖的是统一的标题写法,所以一旦遇到写坏了的场景标题,或者不符合标准的场景标题,它给出的判断并不可靠。
进阶用法可以这样理解:把地点清单和场次数量、日夜标记放在一起查看,在锁定拍摄顺序之前,先形成初步的通告分组。
一步步怎么做
- 贴入最新一稿,确认所有场次的标题前缀写法一致。
- 生成清单,再把同一地点的不同写法统一,避免重复条目。
- 给每个地点标上制作信息:场地类型、日夜负荷、后勤复杂度。
- 结构一变就重跑一次,让筹备数据跟着最新稿走。
按角色分的使用场景
- 编剧:在锁稿之前量一下场景地点铺得有多散。
- 副导演组:几分钟就把拆解表格搭起来。
- 制片人:尽早评估复杂场地带来的风险。
常见的坑
- 场景标题写法不统一,重复条目成倍增加。
- 把抽取出来的数据当成成品,不做统一。
- 大改之后忘了重新抽取。
行业里的做法
- 在把任何东西交给制作组之前,先把命名规范定下来。
- 把地点分组,早点看出通告上能省的地方。
- 维护一张主拆解表,和剧本的版本挂钩。
要把这个工具的输出当成决策时的辅助,而不是把它当作写作本身的替代。一个好剧本之所以被记住,靠的是具体的选择、准确的情绪,以及戏剧动作的清晰。工具的作用是把噪音去掉,让你的精力落到真正要紧的地方,也就是人物、冲突、升级和兑现。每过一轮就回看一次结果,并把接受的改动记下来,你的工作方式会一稿比一稿更快、更可预期。这种稳定正是专业合作者看重的东西:意外更少,理由更清楚,剧本朝着有意识的方向生长。
延伸问答
这能取代完整的场地拆解吗?
答案是不能。它能够加快的是抽取这一步,但在抽取完成之后,仍然需要由人来把命名统一起来,并补上制作类别。
重复的地点大多从哪来?
这种不一致来自各稿之间场景标题的写法不同,举例来说,同一个地方用了两种叫法。
该在改稿前还是改稿后抽取?
都要。早抽看得出规模,改完再抽能让筹备保持最新。
结果怎么整理给通告用?
加上内外景、日夜、实景还是搭景、后勤复杂度这几列。
剧集的分集剧本适用吗?
适用。只要你在场景标题的写法上保持前后统一,那么同一套提取逻辑对试播集和分集都同样成立,不用因为片集类型不同而另外换一套规则。
抽取之后最该做的检查是什么?
人工过一遍重复次数最多的地点,把不同写法合并了再发出去。
关于场景提取和剧本拆解的常见问题
它是一个轻量的小工具,作用就是扫描你手上的剧本、找出其中的场景标题,例如「内景 房子 - 日」或者「外景 街道 - 夜」,随后把这些标题整理成一份清单输出给你,这样一来你就不用从头到尾逐行读完整份文档,也能一眼看到剧本里出现的所有场景。
它的准确度高低,取决于你的剧本格式有多干净、多规范。如果每一个场景标题都以标准前缀开头,工具就能相当可靠地把它们全部抓出来。反过来,如果标题的写法不够标准,就可能出现两种情况:有些场景被直接漏掉,或者同一个场景以略有差异的名字重复出现在清单里。
能,不过有一点需要你留意。提取器给你的是一份快速生成、按字母排序的完整场景标题清单,它确实是做场景拆解时很好的起点,但你仍然要自己在表格或制作软件里做后续处理:清理掉名称里的杂质、把重复项合并起来,并给每个场景分配类别(搭景、实景、特效重头戏)。
当然可以。提取器并不在意剧本的总页数有多少,也不在意幕结构是怎么安排的。你既可以粘贴长片,也可以粘贴试播集、选集其中的一集,或者一部短片。只要其中的场景标题使用了标准前缀,工具就能为任何一种格式生成对应的场景清单。
不会。这个提取器不需要联网,全部处理过程都发生在你自己当前打开的浏览器里。负责查找场景标题、生成场景清单的那部分 JavaScript 代码同样在本地执行,也就是说,从识别场景标题到整理出场景清单,整个流程都在你的设备上完成,不依赖任何外部服务。不会有任何页面被发送到服务器,也不会有任何页面被存储,文档内容始终留在你的电脑上。